---
title: "GPT-6.1 Sol vs Claude Opus 5.5: qué probar en agentes de producción"
description: "Comparación práctica de GPT-6.1 Sol y Claude Opus 5.5: precios oficiales, contexto, herramientas, disponibilidad y un marco de decisión sin benchmarks inventados."
author: "Carlos García"
published: 2026-09-30
updated: 2026-09-30
language: es
human_url: "https://kiia.cloud/es/blog/comparar-sol-vs-opus/"
---
> **En 60 segundos:** GPT-6.1 Sol tiene una tarifa estándar por token que es la mitad de Claude Opus 5.5 en las cuatro líneas comparables publicadas: entrada, lectura de caché, escritura de caché y salida. Sus ventanas son parecidas: 1,05 millones de tokens para Sol y 1 millón para Opus, con 128.000 tokens de salida máxima en ambos. Eso no decide qué modelo completa mejor tu flujo. Elegí dos o tres tareas reales, ejecutalas con las mismas herramientas y controles, y compará resultados aceptados, correcciones, latencia, consumo y fallos. Revisamos las fuentes oficiales el **30 de septiembre de 2026**.
OpenAI lanzó GPT-6.1 Sol el 29 de septiembre como opción para programación compleja y trabajo profesional con menor coste que Astra. Anthropic había presentado Claude Opus 5.5 el 22 de septiembre para coding agéntico, conocimiento y tareas largas. Son dos lanzamientos cercanos, con posiciones distintas dentro de cada catálogo. La comparación útil empieza en el trabajo que el agente debe terminar.
Si necesitás contexto sobre las gamas anteriores, podés leer las guías de [GPT-6 Astra para empresas](/es/blog/gpt-6-astra-agentes-ia-empresas/) y [Claude Opus 5](/es/blog/opus-5-guia/). Este artículo se limita a Sol 6.1 y Opus 5.5.
## Tabla de especificaciones publicadas
| Campo | GPT-6.1 Sol | Claude Opus 5.5 |
| --- | --- | --- |
| ID de API | `gpt-6.1-sol` | `claude-opus-5-5` |
| Posicionamiento del proveedor | Programación compleja, computer use y trabajo profesional con rendimiento cercano a Astra a menor coste | Coding agéntico de larga duración y trabajo de conocimiento |
| Modalidades | Texto de entrada y salida; imagen de entrada; audio y video no soportados | Texto e imagen de entrada; texto de salida |
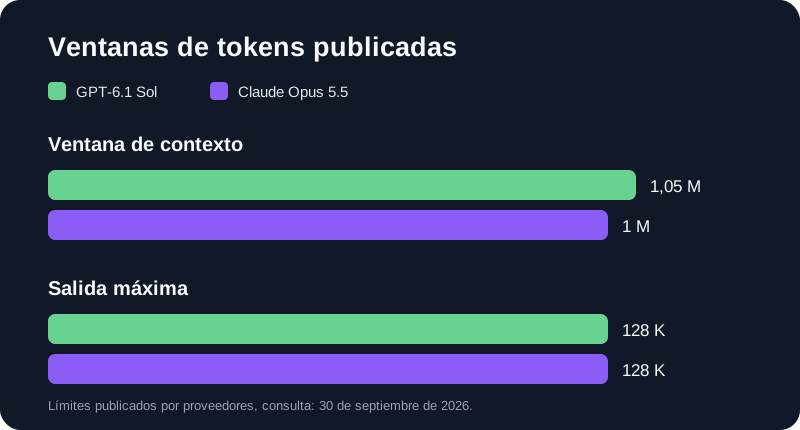
| Ventana de contexto | 1.050.000 tokens | 1.000.000 tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Tool use | Sí. Responses API para llamar herramientas; function calling, web/file search, shell, computer use y MCP publicados | Sí. Tool use y computer use; el toolset y la forma de los bloques cambian respecto a Opus 5 |
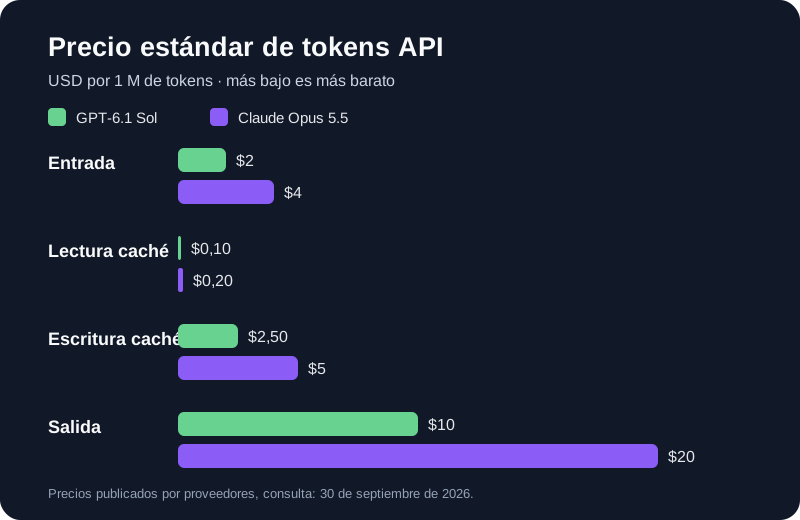
| Precio estándar por 1 M tokens | Entrada USD 2; caché leída USD 0,10; caché escrita USD 2,50; salida USD 10 | Entrada USD 4; caché leída USD 0,20; caché escrita de 5 min USD 5; salida USD 20 |
| Disponibilidad publicada | OpenAI API; residencia de datos en EE. UU. y UE, con restricciones por modo | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS; apps Claude en planes Pro, Max, Team y Enterprise |
| Atención al migrar | No acepta reasoning `none` ni `minimal`; tool calling requiere Responses API | Thinking no se puede desactivar; forced tool use devuelve error; cambian thinking blocks y computer use en algunas plataformas |
Fuentes de la tabla: [ficha de GPT-6.1 Sol](https://developers.openai.com/api/docs/models/gpt-6.1-sol), [changelog de OpenAI](https://developers.openai.com/api/docs/changelog), [ficha de Claude Opus 5.5](https://platform.claude.com/docs/en/models/opus-5-5/overview), [anuncio de Anthropic](https://www.anthropic.com/claude-opus-5-5) y [guía de migración de Opus 5.5](https://platform.claude.com/docs/en/models/opus-5-5/migration-guide). Consulta: **30 de septiembre de 2026**. “No publicado / verificar” aplica a cualquier modalidad, región o integración que no figure en esas páginas.
## El precio nominal favorece a Sol; el coste por resultado todavía se mide
USD por 1 millón de tokens, tarifa estándar. Fuentes: OpenAI, GPT-6.1 Sol y Anthropic, novedades de Opus 5.5. Consulta: 30 de septiembre de 2026. En Sol, los prompts de más de 272.000 tokens tienen multiplicadores de precio; modos rápidos, batch, región y herramientas pueden cambiar la factura.
En esta foto de lista, Opus cuesta exactamente el doble en las cuatro líneas. No concluyas que cada tarea costará el doble. Un agente puede usar distinta cantidad de tokens, repetir herramientas, fallar o terminar con diferente calidad. Medí coste por resultado aceptado, conservando por separado entrada, caché, salida, llamadas a herramientas y reintentos.
Usá el mismo prompt base y el mismo límite de pasos. Si un modelo produce un borrador barato que necesita media hora de corrección, el precio por token escondió el coste dominante. Si ambos pasan la evaluación, la diferencia de tarifa sí se vuelve una señal fuerte.
## Las ventanas son cercanas y la salida máxima es igual
Tokens publicados por solicitud. Fuentes: OpenAI, GPT-6.1 Sol y Anthropic, Claude Opus 5.5. Consulta: 30 de septiembre de 2026. Una ventana mayor no garantiza mejor recuperación ni elimina la necesidad de seleccionar contexto.
La diferencia de 50.000 tokens de contexto rara vez debería decidir sola. Un agente estable no vuelca todo el repositorio, CRM o buzón en cada turno. Recupera lo necesario, conserva trazas y resume cuando corresponde. OpenAI publica un cambio de tarifa para prompts de Sol que superan 272.000 tokens, así que capacidad máxima y coste marginal son preguntas distintas.
## Cómo decidir sin proclamar un ganador universal
### 1. Calidad en tu tarea
No hay un benchmark oficial directo que enfrente GPT-6.1 Sol y Claude Opus 5.5 con el mismo harness, configuración, esfuerzo y salvaguardas. Por eso no incluimos un gráfico de “calidad”. Un espacio en blanco con una estimación sería más vistoso y menos útil.
Prepará entre 20 y 50 casos representativos: tareas normales, instrucciones ambiguas, datos ausentes, fallos de herramienta y acciones prohibidas. Un revisor que no sepa qué modelo produjo cada salida puede marcar aceptación, correcciones y causa de fallo. Conservá la versión del prompt, herramientas, esfuerzo y límites.
### 2. Coste y latencia
Compará el coste total de cada ejecución aceptada. Registrá tokens de entrada, caché y salida, llamadas externas, pasos, reintentos y tiempo de revisión. Para latencia, no copies una promesa comercial entre modos: medí p50 y p95 en la región y el tier que vas a operar.
### 3. Disponibilidad e integración
Sol encaja mejor si el agente ya usa Responses API, herramientas alojadas de OpenAI o requisitos de residencia publicados para EE. UU. y UE. Opus puede encajar si tu contrato y observabilidad ya viven en Claude API, Bedrock, Google Cloud, Microsoft Foundry o Claude Platform on AWS. Confirmá la combinación exacta de modelo, región, toolset y modo antes de diseñar el rollout.
### 4. Cambios incompatibles
Una sustitución de ID puede romper un agente aunque el prompt siga compilando. Al pasar a Sol, revisá reasoning y mové tool calling a Responses API. Al pasar de Opus 5 a 5.5, revisá thinking, forced tool choice, continuidad de bloques y la nueva declaración de computer use. Ejecutá pruebas de contrato sobre streaming y cada herramienta antes de comparar calidad.
### 5. Salvaguardas y control operativo
Anthropic publica salvaguardas para ciberseguridad, biología, anti-distillation y cambios en preserved thinking. Las páginas técnicas de Sol describen límites y herramientas, pero no convierten el modelo en una frontera de permisos. En ambos casos, mantené credenciales acotadas, aprobación para acciones irreversibles, logs, presupuestos de ejecución y un interruptor de parada. El modelo no debe decidir qué puede hacer; esa política pertenece a tu aplicación.
## Un piloto corto que produce una decisión
Elegí un flujo con resultado revisable, por ejemplo resolver un issue acotado o preparar un análisis con citas. Congelá el conjunto de casos y ejecutá ambos modelos con las mismas herramientas, datos y permisos. Guardá cinco medidas por caso: aceptación, minutos de corrección, latencia, coste completo y causa de fallo.
Después separá los resultados por tipo de tarea. Puede que Sol gane en el trabajo rutinario por coste y Opus justifique su tarifa en un subconjunto difícil, o al revés. También puede que la diferencia operativa sea menor que el ruido de los datos. La decisión puede ser enrutar, no casarse con un único modelo.
Repetí la evaluación antes de cambiar snapshots, reasoning, toolsets o salvaguardas. Los números de este artículo describen las fichas oficiales consultadas el 30 de septiembre de 2026; tu prueba describe el sistema que realmente vas a operar.
## Fuentes oficiales
- [OpenAI API changelog](https://developers.openai.com/api/docs/changelog): fecha de lanzamiento, ID, posicionamiento y precio de GPT-6.1 Sol.
- [GPT-6.1 Sol model page](https://developers.openai.com/api/docs/models/gpt-6.1-sol): contexto, salida, modalidades, herramientas, precios y disponibilidad.
- [Using GPT-6](https://developers.openai.com/api/docs/guides/latest-model): selección y notas de migración de la familia GPT-6.
- [Introducing Claude Opus 5.5](https://www.anthropic.com/claude-opus-5-5): lanzamiento, precio, disponibilidad y salvaguardas descritas por Anthropic.
- [Claude Opus 5.5 model page](https://platform.claude.com/docs/en/models/opus-5-5/overview): contexto, salida, posicionamiento y breaking changes.
- [Migrating to Claude Opus 5.5](https://platform.claude.com/docs/en/models/opus-5-5/migration-guide): cambios de thinking, herramientas y computer use.
## Preguntas frecuentes
### ¿GPT-6.1 Sol es más barato que Claude Opus 5.5?
Sí en las tarifas estándar publicadas para tokens: Sol cuesta USD 2 por millón de tokens de entrada y USD 10 de salida, mientras Opus 5.5 cuesta USD 4 y USD 20. La factura real también depende del contexto largo, caché, herramientas, región, modo de procesamiento, reintentos y cantidad de tokens que cada modelo usa para completar la tarea.
### ¿Cuál es mejor para un agente de programación?
Las fuentes de los proveedores no ofrecen un benchmark directo y comparable entre estos dos modelos. Probá ambos con el mismo repositorio, herramientas, permisos y conjunto de tareas; medí resultados aceptados, correcciones, latencia, tokens y fallos de herramientas.
### ¿Se puede migrar cambiando solo el ID del modelo?
No conviene. GPT-6.1 Sol requiere Responses API para tool calling y cambia opciones de reasoning frente a versiones anteriores. Opus 5.5 introduce cambios en thinking, tool choice, bloques de conversación y computer use. Revisá la guía de migración del proveedor y repetí tus evaluaciones antes de mover tráfico.